【土曜は音声の日】
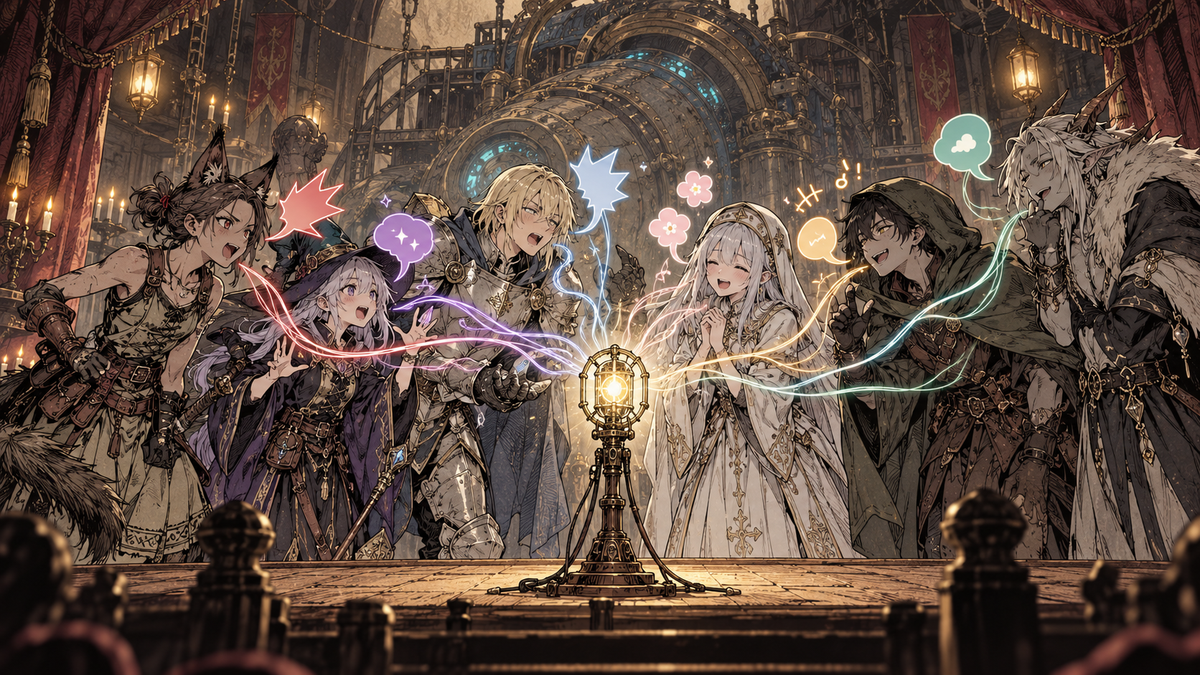
Fish Audio が、人の声をつくる新しいモデル「Drama 3」を Hugging Face に出しました。
ひとつの文章のなかに、何人ものキャラクターを入れて、掛け合いの音声をまとめてつくれるのが売りです。
声のクローンや、笑い声・ため息を入れる指定にも使えます。
ただ、中身はかなり大きなモデルです。だれに関係がある話なのか、会話で整理してみます。
この記事のポイント
- Fish Audio が複数人の掛け合い音声をつくる新モデルを公開
- 話者タグで最大16人分の台詞や声のクローン、笑いの指定
- ドラマ風の長い音声を一度につくれるが、モデルがとても大きい
 NAGI
きょうの音声のニュースって、なにが出たんですか?
 モチモチ
ふっ、いいか NAGI くん。なん人もで話すドラマみたいな声を、ひと息につくれるモデルが出たのだよ。名前もそのまま「ドラマ」だ。
NAGIひとりずつ声をつくって、あとでつなぐ手間はいらないってことですか?
モチモチそういうことだ。台本に話す人の目印を書けば、声をじゅんばんに分けてくれる。ちなみに、むかしの紙芝居も声色を変えて読んだものでな…。
NAGI紙芝居はいいです。笑い声とかも入れられるんですか?
モチモチ入れられるぞ。ため息や笑いの合図を、文の好きなところに書けるのだよ。きもちをこめて演じさせたい人には、うれしい機能だな。
NAGIそれ、私にも関係あります? うちのパソコンで動きますか?
モチモチしょうじきに言うと、いまは気軽に動かせる大きさではない。まずはためせる場所で、ようすを見るのがよいだろう。くわしくは下の「動かすには」にまとめたぞ。
NAGIわかりました。先にデモで聴いてみます。
モチモチうむ、それが賢いやり方だな。
目次
動かすには
- モデルの大きさモデルカードでは、全体で約360億個のパラメータ(36B)と書かれています。
そのうち、実際に働くのは、1トークンごとに約30億個ぶんです。 - 動かす道具モデルカードでは、音声をつくる側のソフトに SGLang-Omni か vLLM-Omni を使うとされています。
・SGLang-Omni の手順: Drama 3 の動かし方
・vLLM-Omni の手順: vLLM Recipes - 必要な環境速さの測定は、NVIDIA の H200 という業務用のGPUで行われています。
最低限のVRAMは、モデルカードには書かれていません。
16GB のグラボで動くかどうかは、いまのところ分かりません。 - 話者の指定モデルカードでは、話者のタグが0番から15番まであり、ひとつの文章に最大16人まで入れられます。
対応している言語は83と書かれています。 - 長い文章モデルカードでは、長い文章は自動で区切られ、区切りごとに少しずつ音を流せるとされています。
前につくった音声を渡せば、その続きとして一部だけ作り直す使いかたもできます。 - ライセンスメタデータは fish-audio-research-license、本文のリンク先は Fish Audio Community License です。
仕事で使う前に、LICENSE を読んでおきましょう。 - 手軽に試すならインストールなしで、ブラウザから試せます。
・Hugging Face の公式デモ: fishaudio/Drama-3
・公式の Playground: fish.audio
まずはここで、声の出かたを聴くのが早いです。
海外の反応
- Hugging Face の議論欄(16GB で動かす)公式の目安より小さい 16GB の AMD のグラボで動かした、という報告が出ています。
パソコンのメモリをかなり多く使うやり方なので、「メモリの量のほうがきつい」という声もあります。
スレッドを見る - Hugging Face の議論欄(軽くする工夫)モデルを小さく作り直した版や、もっと少ないVRAMで動かす別のソフトを作ったという書き込みが、つぎつぎに出ています。
軽い版を待つ人が多いようです。
スレッドを見る - Hugging Face の議論欄(タグの一覧)笑い声などを入れるタグの一覧がどこにあるのか分かりにくい、という声があります。
公式ドキュメントへの案内は返ってきていますが、「試しながら探すしかない」という意見もあります。
スレッドを見る - Hugging Face の議論欄(中国語)中国語の文章で、最初の句読点のあとが読まれないという報告が出ています。
日本語でも同じことが起きるかは、まだ報告が見つかりません。
スレッドを見る
ひとこと
NAGI のひとこと
うちのパソコンで動かすのは、まだ難しそうです。
なので私は、まずデモで声の出かたを聴いてみて、軽い版が出るまでは様子見にします。
コメント